2026年11月6日|会で出会った論文
会の記録ではなく、論文の内容を紹介します。
GODBench:動画コメントアートのためのマルチモーダル大規模言語モデル評価
読み手を推測する:常識推論による自動物語生成の導き方
出典・ライセンス
ACLの2016年以降の資料に関するCC BY 4.0方針を根拠とする掲載候補です。ACL方針は第三者素材を対象外とします。図内の例文・アイコン等について、第三者権利の包括的な確認済みを意味しません。
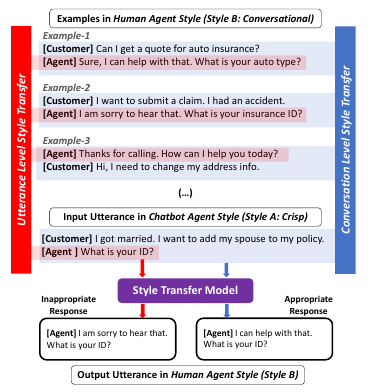
[1] Shamik Roy, Raphael Shu, Nikolaos Pappas, Elman Mansimov, Yi Zhang, Saab Mansour, Dan Roth. Conversation Style Transfer using Few-Shot Learning. Figure 1. ACL掲載版 · arXiv · CC BY 4.0 · 原本PDF。図領域のみ切出し・縮小。図内翻訳・描き直しなし。切出しはページ画像から図全体を含む矩形で再設定。
英語原題:Conversation Style Transfer using Few-Shot Learning
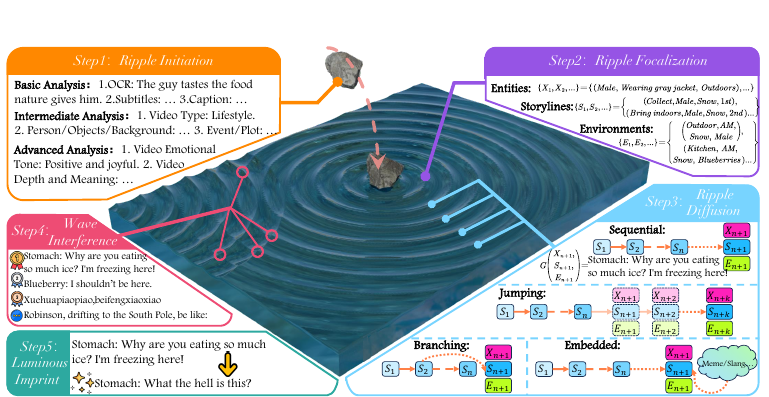
[2] Yiming Lei, Chenkai Zhang, Zeming Liu, Haitao Leng, Shaoguo Liu, Tingting Gao, Qingjie Liu, Yunhong Wang. GODBench: A Benchmark for Multimodal Large Language Models in Video Comment Art. Figure 3. ACL掲載版 · arXiv · CC BY 4.0 · 原本PDF。図領域のみ切出し・縮小。図内翻訳・描き直しなし。切出しはページ画像から図全体を含む矩形で再設定。
英語原題:GODBench: A Benchmark for Multimodal Large Language Models in Video Comment Art
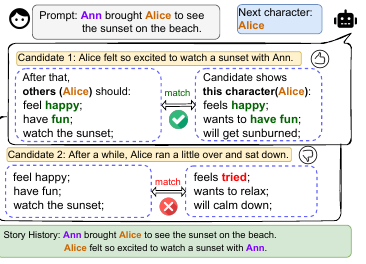
[3] Xiangyu Peng, Siyan Li, Sarah Wiegreffe, Mark Riedl. Inferring the Reader: Guiding Automated Story Generation with Commonsense Reasoning. Figure 1. ACL掲載版 · arXiv · CC BY 4.0 · 原本PDF。図領域のみ切出し・縮小。図内翻訳・描き直しなし。切出しはページ画像から図全体を含む矩形で再設定。
英語原題:Inferring the Reader: Guiding Automated Story Generation with Commonsense Reasoning